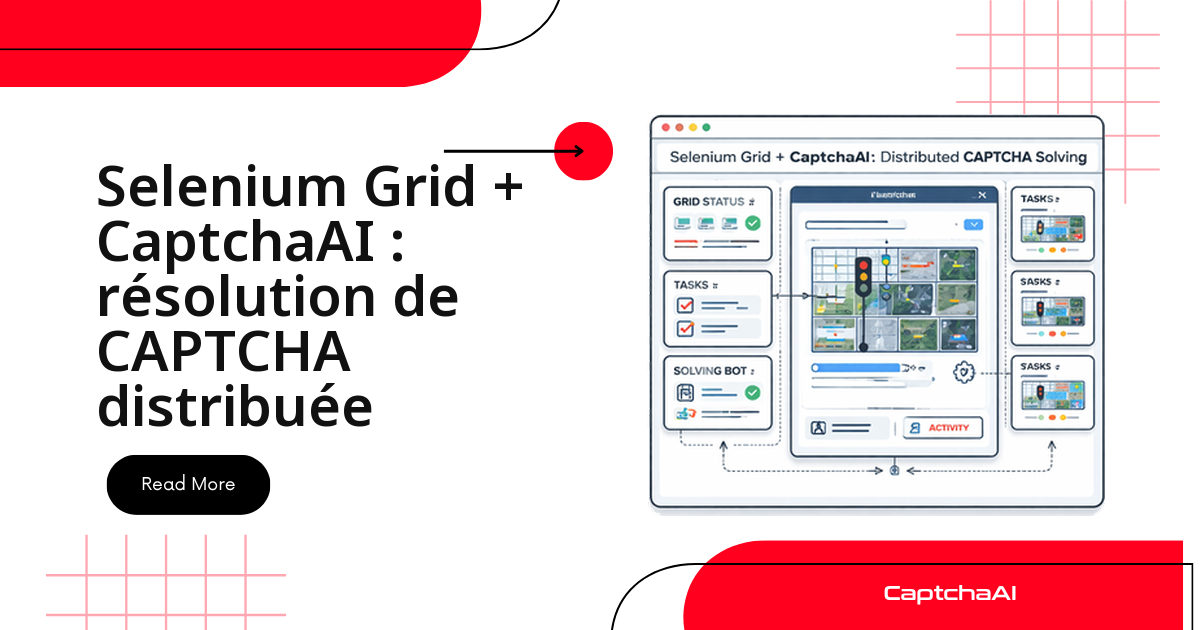
Sur une grille Selenium, ce qui plafonne le débit n'est presque jamais le CAPTCHA lui-même : c'est l'écart entre le nombre de sessions Chrome ouvertes en même temps et le nombre de threads que votre plan CaptchaAI autorise. Alignez ces deux chiffres et trois nœuds traitent quinze formulaires protégés en parallèle sans que rien n'attende côté API.
Selenium Grid répartit les sessions de navigateur sur plusieurs machines ; CaptchaAI expose une seule API que tous les nœuds appellent avec la même clé. Ce guide commence donc par le dimensionnement, monte ensuite la grille avec Docker Compose, branche le client de résolution, puis passe au HPA Kubernetes et à Java.
Dimensionner les threads avant d'ajouter des nœuds
Un nœud Chrome lancé avec SE_NODE_MAX_SESSIONS=5 occupe cinq slots. Si vos tâches passent chacune par un défi CAPTCHA, ces cinq sessions demandent un token à peu près au même moment : il vous faut donc au moins autant de threads disponibles que de sessions réellement simultanées, sans quoi les résolutions se mettent en file d'attente pendant que des navigateurs restent bloqués sur la page.
| Sessions simultanées visées | Nœuds Chrome (5 sessions) | Plan CaptchaAI |
|---|---|---|
| 5 | 1 | BASIC ($15/mois, 5 threads) |
| 15 | 3 | STANDARD ($30/mois, 15 threads) |
| 50 | 10 | ADVANCE ($90/mois, 50 threads) |
| 100 | 20 | PREMIUM ($170/mois, 100 threads) |
La facturation CaptchaAI porte sur le thread, pas sur la résolution : chaque thread accepte un nombre illimité de résolutions dans le mois, sans frais par CAPTCHA ni surcoût selon le type. Concrètement, doubler la fréquence de vos campagnes de tests ne change pas la facture ; seul le parallélisme la change. Les prix sont en dollars US.
Un thread, c'est une résolution en cours : dès que le token revient, le thread enchaîne la tâche suivante.
Comment Selenium Grid, les nœuds et l'API s'articulent
Le client pilote le hub, le hub distribue les sessions aux nœuds, et chaque nœud appelle l'API CaptchaAI avec la même clé : rien d'autre ne s'intercale.
┌─────────────┐     ┌──────────────┐     ┌──────────────┐
│  Test Script │────▶│  Grid Hub    │────▶│  Node 1      │
│  (Client)    │     │  (Router)    │     │  Chrome x 5  │
└─────────────┘     └──────────────┘     └──────────────┘
                           │              ┌──────────────┐
                           ├─────────────▶│  Node 2      │
                           │              │  Chrome x 5  │
                           │              └──────────────┘
                           │              ┌──────────────┐
                           └─────────────▶│  Node 3      │
                                          │  Chrome x 5  │
                                          └──────────────┘

All nodes share ──▶ CaptchaAI API (single API key)
Étape 1 : monter Selenium Grid 4 avec Docker Compose
Trois nœuds Chrome et un hub suffisent pour un premier parc. SE_NODE_OVERRIDE_MAX_SESSIONS=true est indispensable : sans lui, Selenium retombe sur le nombre de cœurs de la machine.
version: "3"
services:
  selenium-hub:
    image: selenium/hub:4.21.0
    container_name: selenium-hub
    ports:

      - "4442:4442"
      - "4443:4443"
      - "4444:4444"

  chrome-node-1:
    image: selenium/node-chrome:4.21.0
    depends_on:

      - selenium-hub
    environment:

      - SE_EVENT_BUS_HOST=selenium-hub
      - SE_EVENT_BUS_PUBLISH_PORT=4442
      - SE_EVENT_BUS_SUBSCRIBE_PORT=4443
      - SE_NODE_MAX_SESSIONS=5
      - SE_NODE_OVERRIDE_MAX_SESSIONS=true

  chrome-node-2:
    image: selenium/node-chrome:4.21.0
    depends_on:

      - selenium-hub
    environment:

      - SE_EVENT_BUS_HOST=selenium-hub
      - SE_EVENT_BUS_PUBLISH_PORT=4442
      - SE_EVENT_BUS_SUBSCRIBE_PORT=4443
      - SE_NODE_MAX_SESSIONS=5
      - SE_NODE_OVERRIDE_MAX_SESSIONS=true

  chrome-node-3:
    image: selenium/node-chrome:4.21.0
    depends_on:

      - selenium-hub
    environment:

      - SE_EVENT_BUS_HOST=selenium-hub
      - SE_EVENT_BUS_PUBLISH_PORT=4442
      - SE_EVENT_BUS_SUBSCRIBE_PORT=4443
      - SE_NODE_MAX_SESSIONS=5
      - SE_NODE_OVERRIDE_MAX_SESSIONS=true
docker-compose up -d
Vérifiez ensuite http://localhost:4444 : la console doit afficher trois nœuds et quinze slots. Prévoyez environ 1 Go de RAM par session Chrome, sinon le nœud sera coupé pour dépassement mémoire avant votre premier token.
Étape 2 : brancher le client de résolution sur la grille
La classe ci-dessous fait trois choses : elle ouvre une session distante sur la grille, elle envoie le défi à in.php, puis elle interroge res.php jusqu'à obtenir le token. Le token reCAPTCHA v2 est ensuite injecté dans g-recaptcha-response avant la soumission du formulaire ; la méthode solve_turnstile couvre Cloudflare Turnstile selon le même schéma.
Deux détails comptent ici : une interrogation toutes les 5 secondes suffit, et driver.quit() doit rester dans un finally — sinon une exception laisse un slot occupé.
import requests
import time
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from concurrent.futures import ThreadPoolExecutor, as_completed


class GridCaptchaSolver:
    CAPTCHAAI_URL = "https://ocr.captchaai.com"

    def __init__(self, api_key, grid_url="http://localhost:4444"):
        self.api_key = api_key
        self.grid_url = grid_url

    def create_session(self):
        """Create a new browser session on the Grid."""
        options = webdriver.ChromeOptions()
        options.add_argument("--no-sandbox")
        options.add_argument("--disable-blink-features=AutomationControlled")
        options.add_argument("--window-size=1920,1080")

        driver = webdriver.Remote(
            command_executor=self.grid_url,
            options=options,
        )
        return driver

    def solve_recaptcha_v2(self, site_url, sitekey):
        """Solve reCAPTCHA v2 via CaptchaAI API."""
        # Submit
        resp = requests.post(f"{self.CAPTCHAAI_URL}/in.php", data={
            "key": self.api_key,
            "method": "userrecaptcha",
            "googlekey": sitekey,
            "pageurl": site_url,
            "json": 1,
        })
        data = resp.json()
        if data["status"] != 1:
            raise Exception(f"Submit: {data['request']}")

        task_id = data["request"]

        # Poll
        for _ in range(60):
            time.sleep(5)
            resp = requests.get(f"{self.CAPTCHAAI_URL}/res.php", params={
                "key": self.api_key, "action": "get",
                "id": task_id, "json": 1,
            })
            data = resp.json()
            if data["request"] == "CAPCHA_NOT_READY":
                continue
            if data["status"] != 1:
                raise Exception(f"Solve: {data['request']}")
            return data["request"]

        raise Exception("Timeout")

    def solve_turnstile(self, site_url, sitekey):
        resp = requests.post(f"{self.CAPTCHAAI_URL}/in.php", data={
            "key": self.api_key, "method": "turnstile",
            "sitekey": sitekey, "pageurl": site_url, "json": 1,
        })
        data = resp.json()
        if data["status"] != 1:
            raise Exception(f"Submit: {data['request']}")

        task_id = data["request"]
        for _ in range(60):
            time.sleep(5)
            resp = requests.get(f"{self.CAPTCHAAI_URL}/res.php", params={
                "key": self.api_key, "action": "get",
                "id": task_id, "json": 1,
            })
            data = resp.json()
            if data["request"] == "CAPCHA_NOT_READY":
                continue
            if data["status"] != 1:
                raise Exception(f"Solve: {data['request']}")
            return data["request"]

        raise Exception("Timeout")

    def process_task(self, task):
        """Process a single CAPTCHA-protected task on a Grid node."""
        driver = self.create_session()

        try:
            driver.get(task["url"])
            time.sleep(2)

            # Detect sitekey
            sitekey = task.get("sitekey")
            if not sitekey:
                sitekey = driver.execute_script(
                    "return document.querySelector('[data-sitekey]')?.getAttribute('data-sitekey')"
                )

            if not sitekey:
                return {"url": task["url"], "status": "no_captcha", "data": driver.page_source[:500]}

            # Solve
            token = self.solve_recaptcha_v2(task["url"], sitekey)

            # Inject
            driver.execute_script(f"""
                document.querySelector('#g-recaptcha-response').value = '{token}';
                document.querySelectorAll('[name="g-recaptcha-response"]').forEach(
                    el => el.value = '{token}'
                );
            """)

            # Fill form and submit
            if task.get("form_data"):
                for field, value in task["form_data"].items():
                    driver.find_element(By.NAME, field).send_keys(value)

            if task.get("submit_selector"):
                driver.find_element(By.CSS_SELECTOR, task["submit_selector"]).click()
                time.sleep(3)

            return {
                "url": task["url"],
                "status": "success",
                "result_url": driver.current_url,
                "data": driver.page_source[:1000],
            }

        except Exception as e:
            return {"url": task["url"], "status": "error", "error": str(e)}

        finally:
            driver.quit()
Étape 3 : lancer les tâches en parallèle
Un ThreadPoolExecutor côté client suffit à saturer la grille : chaque worker ouvre sa propre session, donc le nombre de workers est votre vrai parallélisme. Gardez-le sous le nombre de slots libres et laissez un timeout généreux sur future.result().
def run_parallel_tasks(api_key, tasks, max_workers=10):
    """Run CAPTCHA tasks in parallel across Grid nodes."""
    solver = GridCaptchaSolver(api_key)
    results = []

    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        futures = {
            executor.submit(solver.process_task, task): task
            for task in tasks
        }

        for future in as_completed(futures):
            task = futures[future]
            try:
                result = future.result(timeout=600)
                results.append(result)
                print(f"[{result['status']}] {result['url']}")
            except Exception as e:
                results.append({
                    "url": task["url"],
                    "status": "exception",
                    "error": str(e),
                })

    return results


# Usage
tasks = [
    {
        "url": "https://site-a.com/form",
        "sitekey": "6Le-wvkSAAAAAPBMRTvw0Q4Muexq9bi0DJwx_mJ-",
        "form_data": {"name": "Test User", "email": "[email protected]"},
        "submit_selector": "#submit",
    },
    {
        "url": "https://site-b.com/register",
        "sitekey": "6LdKlZEpAAAAAAOQjzC2v_mJ-",
        "form_data": {"username": "testuser"},
        "submit_selector": "button[type='submit']",
    },
    # Add more tasks...
]

results = run_parallel_tasks("YOUR_API_KEY", tasks, max_workers=15)

# Summary
success = sum(1 for r in results if r["status"] == "success")
print(f"\nCompleted: {success}/{len(results)} successful")
Étape 4 : caler le nombre de workers sur la capacité réelle
Écrire max_workers en dur fonctionne jusqu'au jour où un nœud tombe. L'endpoint /status du hub renvoie l'état de chaque slot : lisez-le au démarrage du lot, puis ajustez.
import requests

def check_grid_status(grid_url="http://localhost:4444"):
    """Check Selenium Grid status and available nodes."""
    try:
        resp = requests.get(f"{grid_url}/status")
        data = resp.json()

        nodes = data.get("value", {}).get("nodes", [])
        total_slots = 0
        available_slots = 0

        print(f"Grid Status: {data['value']['ready']}")
        print(f"Nodes: {len(nodes)}")

        for i, node in enumerate(nodes):
            slots = node.get("slots", [])
            free = sum(1 for s in slots if not s.get("session"))
            total_slots += len(slots)
            available_slots += free
            print(f"  Node {i+1}: {free}/{len(slots)} slots available")

        print(f"Total capacity: {available_slots}/{total_slots} available")
        return available_slots

    except Exception as e:
        print(f"Grid check failed: {e}")
        return 0


# Adjust workers based on grid capacity
available = check_grid_status()
optimal_workers = min(available, 20)
print(f"Optimal workers: {optimal_workers}")
Journalisez cette capacité : une grille passée de 15 à 9 slots explique souvent, à elle seule, des temps qui semblent s'être dégradés.
Mise à l'échelle automatique de Selenium Grid avec Kubernetes
Sur Kubernetes, les nœuds Chrome deviennent un Deployment et le HorizontalPodAutoscaler ajuste les répliques selon le CPU. Calez maxReplicas sur ce que vos threads absorbent : 20 nœuds avec un plan à 15 threads déplacent simplement l'attente vers l'API.
# selenium-grid-k8s.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: selenium-chrome-node
spec:
  replicas: 5
  selector:
    matchLabels:
      app: selenium-chrome
  template:
    metadata:
      labels:
        app: selenium-chrome
    spec:
      containers:

        - name: chrome
          image: selenium/node-chrome:4.21.0
          env:

            - name: SE_EVENT_BUS_HOST
              value: selenium-hub

            - name: SE_EVENT_BUS_PUBLISH_PORT
              value: "4442"

            - name: SE_EVENT_BUS_SUBSCRIBE_PORT
              value: "4443"

            - name: SE_NODE_MAX_SESSIONS
              value: "3"
          resources:
            limits:
              memory: "2Gi"
              cpu: "1"
            requests:
              memory: "1Gi"
              cpu: "500m"
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: chrome-node-hpa
spec:
  scaleRef:
    apiVersion: apps/v1
    kind: Deployment
    name: selenium-chrome-node
  minReplicas: 2
  maxReplicas: 20
  metrics:

    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70
La même intégration côté Java
Avec JUnit ou TestNG, rien ne change de langage : RemoteWebDriver pointe vers le hub et un ExecutorService remplace le pool Python.
import org.openqa.selenium.WebDriver;
import org.openqa.selenium.remote.RemoteWebDriver;
import org.openqa.selenium.chrome.ChromeOptions;
import java.net.URL;
import java.net.http.*;
import java.net.URI;
import java.util.concurrent.*;

public class GridCaptchaSolver {
    private final String apiKey;
    private final String gridUrl;
    private final HttpClient httpClient;

    public GridCaptchaSolver(String apiKey, String gridUrl) {
        this.apiKey = apiKey;
        this.gridUrl = gridUrl;
        this.httpClient = HttpClient.newHttpClient();
    }

    public WebDriver createSession() throws Exception {
        ChromeOptions options = new ChromeOptions();
        options.addArguments("--no-sandbox", "--window-size=1920,1080");
        return new RemoteWebDriver(new URL(gridUrl), options);
    }

    public List<Map<String, String>> runParallel(
        List<Map<String, String>> tasks, int workers
    ) throws Exception {
        ExecutorService executor = Executors.newFixedThreadPool(workers);
        List<Future<Map<String, String>>> futures = new ArrayList<>();

        for (Map<String, String> task : tasks) {
            futures.add(executor.submit(() -> processTask(task)));
        }

        List<Map<String, String>> results = new ArrayList<>();
        for (Future<Map<String, String>> future : futures) {
            results.add(future.get(600, TimeUnit.SECONDS));
        }

        executor.shutdown();
        return results;
    }
}
Exploitation quotidienne : hébergement, RGPD et coûts
Un exemple concret. Une équipe QA lilloise héberge hub et nœuds sur OVHcloud à Gravelines, avec un parc Scaleway pour les campagnes de nuit, et vise ses propres environnements de recette protégés par reCAPTCHA v2. La latence réseau vers l'API y reste marginale devant le temps de résolution, et le budget se pilote au plan : passer de STANDARD ($30/mois, 15 threads) à ADVANCE ($90/mois, 50 threads) le temps d'une refonte, puis revenir.
Côté conformité, les extraits de page_source renvoyés par process_task peuvent contenir des données personnelles saisies dans vos formulaires. Tronquez-les, préférez des jeux de données synthétiques et vérifiez vos obligations RGPD avant de conserver ces logs ; les artefacts CI s'en trouvent aussi allégés.
Dépannage
| Symptôme | Cause probable | Correctif |
|---|---|---|
SessionNotCreated |
plus aucun slot libre sur la grille | ajoutez un nœud ou augmentez SE_NODE_MAX_SESSIONS |
| Timeout à la création de session | nœud saturé | réduisez les sessions simultanées par nœud |
WebDriverException en cours de test |
nœud déconnecté du hub | ajoutez un retry sur la création de session |
| Mémoire épuisée sur le nœud | trop d'instances Chrome ouvertes | fixez resources.limits et un maximum de sessions |
CAPCHA_NOT_READY jusqu'au timeout |
boucle d'interrogation trop courte ou API chargée | allongez le délai d'expiration et ajoutez une nouvelle tentative |
| Slots occupés par des sessions fantômes | nettoyage différé par le hub | définissez SE_SESSION_TIMEOUT |
FAQ
Que se passe-t-il si toutes mes sessions demandent un token en même temps ?
Elles attendent qu'un thread se libère. Rien n'échoue, mais le temps de résolution perçu augmente : réduisez max_workers ou montez d'un plan.
Faut-il un proxy différent par nœud de la grille ?
Pas pour la résolution elle-même. Ajoutez des proxys si vos cibles exigent une origine géographique précise, attachés au navigateur du nœud.
Comment éviter que l'interrogation du résultat immobilise un slot ?
Séparez les deux durées : le SE_SESSION_TIMEOUT du nœud doit dépasser la durée maximale de votre boucle de polling. Sinon le hub recycle la session pendant que le token est encore en route.
CaptchaAI prend-il en charge hCaptcha sur une grille Selenium ?
Non, hCaptcha n'est pas pris en charge, pas plus que FunCaptcha (Arkose Labs). Les types couverts ici sont reCAPTCHA v2, reCAPTCHA v3, Cloudflare Turnstile, Cloudflare Challenge et GeeTest v3 ; GeeTest v4 est annoncé comme à venir.
Guides connexes
- Piloter Chrome via le DevTools Protocol
- Intercepter les requêtes du navigateur pendant un test
- Résolution parallèle avec les worker threads Node.js
Faites résoudre les CAPTCHA par tous les nœuds de votre grille — récupérez votre clé CaptchaAI et déployez en quelques minutes.